Ikke-afhentet: Arbejder du hos Hive?
Hive Anmeldelser: 4.2/5 — Solidt valg
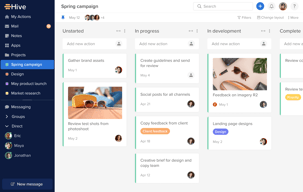
Hive er et alt-i-et projektstyringsværktøj udviklet til at "hjælpe teams med at bevæge sig hurtigere", uanset hvordan de arbejder. Funktioner oprettes baseret på brugernes ønsker og opdateres ugentligt, hvilket gør Hive til verdens første demokratiske softwareplatform. Det er bedst kendt for sine muligheder inden for projektstyring, tidsstyring, teamsamarbejde, automatisering og en række integrationer med tredjepartssoftware. Hive er gratis at bruge for solo-brugere og med premium-versioner tilgængelige for teams og virksomheder.
| Capabilities |
API
|
|---|---|
| Segment |
Lille virksomhed
Midtmarked
Enterprise
|
| Deployment | Cloud / SaaS / Web-baseret, mobil Android, mobil iPad, mobil iPhone |
| Støtte | 24/7 (liverepræsentant), chat, e-mail/helpdesk, ofte stillede spørgsmål/forum, vidensbase, telefonisk support |
| Kurser | Dokumentation |
| Sprog | Engelsk |

Sammenlign Hive med andre populære værktøjer i samme kategori.
Fantastisk og attraktiv brugergrænseflade. Ligetil, når det kommer til sporing, tildeling og overvågning af projekter. Hive hjælper mig med at holde styr på alle vores projekter og personer, der er forbundet med disse projekter.
Jeg har ikke noget at sige som en modvilje endnu. Jeg er tilfreds med at bruge Hive.
Styring af projekter og indhentning af tidslogge

Hive er det bedste datawarehouse og open source. Nem at bruge. Det har forespørgselssproget HiveQL. Syntaksen er den samme som SQL. Så det er nemt at skrive Hive-forespørgsler og nemt at få rapporter og forretningsindsigt. Bedste Olfor-analyse. Og nem at integrere med Spark, Hadoop og cloud.
Højere latenstid er ulempen. Der bør udvikles for at forbedre latenstiden for de komplekse forespørgsler.
Hjælper os med at få forretningsindsigt og rapportering. Hjælper os med at analysere dataene og drage konklusioner for at forbedre forretningen.

Det bedste ved Hive er, at det giver os mulighed for at skrive kode i SQL til behandling og administration af data. Det giver os mulighed for at partitionere og distribuere dataene mellem klyngemaskinerne. Vi kan også vælge en eksekveringsmotor som Spark, Tez og Mapredice, mens vi kører i Hive. Hvis du behandler og analyserer store mængder batchdata, er Hive bedst.
Den understøtter kun strukturdata, og vi kan heller ikke foretage opdateringer. Understøtter kun OLAP.
Vi administrerer vores data warehouse til analytiske formål ved hjælp af Hive. Vi plejede at partitionere og klynge tabellerne for bedre parallel behandling og mindre omrokering, så behandlingen bliver optimeret. Vi plejede også at læse Hive-tabellerne med Spark for bedre beregning og hastighed.

God forespørgsel på Hive-databaser og nem oprettelse af skemaer
Det tillader ikke konvertering af datatyper. Da det vil resultere i tab af data.
Forespørger på Hive-databasen. Også HS2 og Hive-metastore, hvilket resulterer i hurtige resultater.
Skema på HDFS-filer i alle formater. Nem at downloade data. Et komplet værktøj, der ligner et databaseværktøj som Toad.
Ydeevne, nogle gange er det meget vanskeligt at køre forespørgsler. GUI'en kan forbedres med mere brugervenlige muligheder.
Databehandling til lovgivningsmæssig rapportering ...vedligeholdelse af afstamning
Jeg var en stor fan af Impala i et stykke tid, indtil jeg stødte på en række begrænsninger, der var umulige at overvinde. Jeg arbejder meget med arrays, og alene det faktum, at jeg kunne bruge array_contains i Impala, fik mig til at skifte til Hive. Vi bevæger os også hurtigt i retning af hjemmelavede Macross til Hive, der lader os udføre komplekse forespørgsler uden lateral view explodes.
Oprettelse af en session tager et stykke tid, og hastigheden er ret langsom sammenlignet med Impala
Kompleks dataanalyse med tabeller, der har flere milliarder rækker efter partition
Den er meget fleksibel i konfigurationer. Der er så mange muligheder for at indlæse data - direkte fra Linux-filsystemet eller HDFS. Du kan oprette eksterne og administrerede tabeller. En sjov funktion er, at du også kan affyre bash-kommandoer fra Hive.
Den kan ikke bruges til streaming af data. Fejllogning kan forbedres, så fejlsporing og -løsning kan være mere effektiv.
Det bruges til at transformere og behandle Big Data-datasæt i batches. Det kan håndtere store mængder data. Push-prædikatfunktionen har forbedret forespørgslernes ydeevne betydeligt, og udvikleren behøver ikke længere at tænke over det.
Hive er fantastisk til håndtering af logs i big data-projekter. Vi bruger det samme i vores projekt, og det er fantastisk til at bruge joins og gruppering, hvilket er meget vanskeligt og tricky i forbindelse med map reduce. Det har mange UDF-pakker, og det er meget nemt at tilføje nye UDF'er. Vi brugte også bucketing og clustering til at optimere forespørgslen. Konceptet med eksterne tabeller og den måde, vi kan manipulere data på, selv når tabellen er slettet fra Hive, er virkelig fantastisk. Der er mange connectorer tilgængelige på markedet til forskellige softwareprogrammer.
Det jeg ikke kan lide er latenstid og måden den gemmer data på. Når jeg indsætter data, er jeg nødt til at vente mange få poster. Compilerens udførelsesplan er meget umoden, da den ikke udfører ordentlig forespørgselsoptimering. Selvom fællesskabet arbejder hurtigt på at overvinde det hurtigt, tror jeg, det vil tage tid for Hive at være færdig.
Vi bruger Hive primært til at gemme vores logfiler. Det hjælper os med at holde styr på, hvilke poster der er indsat, hvilke poster der er fejlet, og hvad der er forholdet mellem dem. Vi bruger Tableau til at analysere data.
Udviklingen af funktioner, hastighed osv. giver mig den strategiske selvtillid, jeg har brug for i SQL'en i Hadoop-rummet.
På nuværende tidspunkt er alt på pint, og teorierne er fantastiske i Hive 1.2.
At udlede værdi fra masser af ustruktureret og struktureret data.
1) evne til at håndtere PetaByte-dataskala 2) evne til at arbejde med næsten SQL-forespørgselssprog 3) skemabaseret læsekapacitet
1) optimeringsteknologien er stadig under modning
1) håndtering af enorme datasæt 2) håndtering af semistrukturerede og strukturerede datasæt med det samme værktøj
Den SQL-lignende syntaks gør den nem at bruge
Dens afhængighed af mapreduce gør det til tider meget langsomt, selv for en simpel opgave.
Kør specifikke forespørgsler på hadoop-filer
Muligheden for at se HDFS-data i et relationelt format og nemt forespørge dem via HiveQL
Det faktum, at den bruger MapReduce, uanset om du forespørger på en eksisterende tabel eller udfører en kompleks forespørgsel, hjælper Tez med dette problem. Manglende evne til at slette/opdatere data er også et reelt problem og tvinger andre tjenester til at blive brugt, f.eks. HBase.
Muligheden for at bruge Hive på HUE er perfekt. Vi er ved at bygge en platform til data scientists (foretrækker GUI frem for shell) til at udføre analyser, så det er fremragende at fjerne behovet for kommandolinjer.
Det er meget nemt at bruge, fordi du bruger det, som om du bruger et simpelt SQL-sprog til at forespørge data. Da jeg lige startede, havde jeg ingen erfaring med Hive, og på omkring en uge var jeg i stand til at forespørge på big data og lave nogle analyser. På en måned var jeg i stand til at administrere data og oprette mine egne databaser med de nyttige data...
Ikke så mange implementerede funktioner i Hive. Der er meget nyttige Window-funktioner, men det er ikke nok... Det er ikke så simpelt at ændre data i en tabel...
Analysér brugeroplevelsen, brugeradfærden i applikationer eller webklienter hver dag og hver time eller endda hvert minut osv.
Hive er et af Apache-projekterne. Det er data warehouse-software, der letter forespørgsler og administration af store datasæt, der findes i distribueret lagring. Det giver en måde at muliggøre nem dataudtrækning/transformation/indlæsning (ETL). Nogle af de gode funktioner inkluderer (1) et simpelt SQL-lignende forespørgselssprog, kaldet HiveQL, der gør det muligt for brugere, der er fortrolige med SQL, at forespørge dataene. Men det er lidt anderledes end SQL-standarden. For eksempel kan HiveQL også udvides med brugerdefinerede skalarfunktioner (UDF'er), aggregeringer (UDAF'er) og tabelfunktioner (UDTF'er). (2) Du kan definere dit eget læse- eller skrivedataformat kaldet Hive SerDe. (3) Hive kan køre på Hadoop og HDFS. Det har meget god skalerbarhed. Personligt bruger jeg Hive primært til ad hoc-forespørgsler og rapporter. Til BI-rapporter er Hive det bedste, da du kan genbruge al den SQL, du har lavet til traditionelle data warehouses. Med Hive Server2 får du også en reel JDBC-understøttelse, så du kan tilslutte dine BI-værktøjer til det. Mange flere SQL-funktioner som kuber, rollups, windowing, lag, lead osv. bliver tilføjet til Hive gennem Hortonworks Stinger-initiativet. Hive producerer også meget kompakt kode, hvilket altid er godt til læsning og fejlfinding.
For stor kodebase. Den er svær at vedligeholde og understøtte. Og der er for mange konfigurationer. Hvis du kigger på HiveConf.java, vil du blive forvirret af de mange konfigurationer der. Det er nemt at fare vild, når du konfigurerer dem. Og hvis du konfigurerer nogle af dem på en forkert måde, kan du opleve dårlig forespørgselsydeevne.
Vi udvikler Hive. Hive er en del af vores produkt
Apache Hive er et værktøj bygget oven på Hadoop til analyse af store, ustrukturerede datasæt. De fleste BI- og SQL-udviklerværktøjer kan oprette forbindelse til Hive lige så nemt som til enhver anden database.
Kan ikke annullere en kørende forespørgsel. Forespørgselsjustering er vanskeligere sammenlignet med RDBMS
Vi havde et krav om at scanne et stort datasæt til vores prædiktionsalgoritme. I starten brugte vi RDBMS, men ydeevnen var meget langsom, og brugerne var ikke tilfredse med det. Vi erstattede RDBMS med Hive, og vi kan se en drastisk forbedring af ydeevnen.
HiveQL minder mere om SQL og er virkelig nem at lære
Fungerer ikke godt, hvis du vil have forespørgsler med lav latenstid
ydeevne for 1 TB data
Hvis du kender SQL, vil du hurtigt kunne få fat i Hive. Der er masser af den samme funktionalitet, men ikke ligefrem SQL. Det er nemt at oprette tabeller og begynde at skrive forespørgsler, så du kan dykke dybere ned i dine data.
Som med alle Hadoop-værktøjer er der mange knapper at justere. Det tager en del tid at optimere og finjustere din Hive-installation.
Struktur på ustruktureret. Da vi valgte Hive til at udføre den førnævnte opgave, kunne vi hurtigt levere vores data til vores data scientists. En lettere grad af accept af Big Data-ideen.
Det er betagende, hvor godt den problemfrit forbinder arbejdet gennem dens gruppebeskeder, der fremmer samarbejde, dens fleksible projektlayouts, kundeindsigt og anmeldelser, der hjælper med strategien.
En ting at bemærke er, at det bruger meget RAM, og det kræver nok RAM til at gøre nogle integrerede apps langsommere. Det er et problem, der skal løses.
Den har brugt dataanalyse af arbejdsgange til at afdække, hvordan arbejdet rent faktisk udføres, hvad der skal til for at optimere driften, hvordan man planlægger, allokerer og meget mere. Det har været en stor hjælp til at få alle til at præstere og bevæge sig i henhold til tidsfrister og mål.
Hive tilbyder værktøjer til projektplanlægning, herunder muligheden for at spore projekt og tidslinje, oprette og tildele opgaver og administrere ressourcer.
Jeg har ingen afsky for Hive, da det er den jeg bruger.
Det giver brugerne mulighed for at analysere store mængder struktur- og semistrukturdata
Hive er et meget værdifuldt værktøj, da det leverer wrappers til dataanalyse og forespørgsler på big data for organisationer med enorme mængder data, der skal behandles. Det er bygget oven på Hadoop og gør det ret nemt at opbygge og gemme SQL-forespørgsler!
Den største ulempe ved at bruge Hive er, at det ikke leverer eller tilbyder forespørgsler i realtid, især ikke til opdateringer på rækkeniveau, da latensen er ret høj i Hive.
Hive løser problemet med big data-behandling og -analyse for mig og min virksomhed. Vi er i stand til at behandle og analysere enorme mængder data ved hjælp af funktionerne i Hive. Det muliggør også parallel behandling, hvilket gør det ret hurtigt at bruge.

Filformater til optimeringer, eksterne
kan ikke analysere ustrukturerede data, ikke meget hurtigere når det kommer til komplekse operationer på meget store datamængder
adhoc-analyse og batchanalyse af big data

Datadistributionen og databehandlingen i Hive er meget god. DDL- og DML-funktionerne i Hive er bedre end konventionelle SQL-databaser. Hive er bedre kendt for fejlmodstand.
Dataoutputtet på Hive er meget langsomt. Databehandlingen er meget langsom, og outputtet er forsinket på grund af denne langsomme behandling. Syntaksen er også lidt kompleks end i konventionelt SQL-sprog.
Fejltolerance er en meget god funktion, der hjælper med datalagring. Hvis en database går tabt, oprettes der ingen sikkerhedskopi, og denne database kan nemt og intakt gendannes.

brugervenligheden og dens brugerflade er bedst
kørsel af forespørgsler i langsom tilstand med kortreduceret
lagring af store mængder data og hentning af dem via forespørgsler
Caso contrário, se você escrevê-lo como um SQL normal, pode levar horas para processar Mas é um pouco diferente do padrão SQL Pessoalmente falando, eu uso hive principalmente para ad hoc quires e relatórios é ummento de gerazenaquemento de gerazena facility de grandes conjuntos de dados residindo em armazenamento distribuído
O ajuste de desempenho é difícil e torna-se difícil para consultas complexas, ele ainda tem alguns bugs, como todos os dados que vão para um único redutor, o que pode levar a retardar os resultados da consulta. -> Algumas das operações SQL não funcionam på colméia, como as associações de não igualdade, os dados não podem ser atualizados, mas teremos que reecrever
Estamos desenvolvendo o Hive Para pessoas que estão acostumadas a escrever consultas SQL, seria muito bom usar o Hive em cima do hadoop para arquivos armazenados no HDFS. Atividade til dumping-webstedet. Streaming af Big Data, som er som logfiler uden Hive.
- Brugervenlig grænseflade - flere klienter (CLI'er) - nem fejlfinding ved hjælp af fuldt beskrivende logfiler - produktet forbedres konstant for at opfylde alle databaseudviklerkrav - kan tilgås fra flere applikationer - adgang via knox for ekstra sikkerhed - ingen indeksering - flere filformater - tez-arkitekturen
- autentificeringshuller - problemer ved routing gennem zookeeper - ikke så modent værktøj som de almindelige databaseværktøjer
- BI-teamet hjælper alle virksomhedsbrugere med at indtage og tilgå data fra Hadoop - de fleste brugere er velbevandrede i standard SQL-værktøjer - for at skabe en Hadoop-løsning, der dækker hele virksomheden, træner vi alle brugere i Hive.
Nem at komme i gang. Udnytter SQL-viden. Har rimelig dokumentation. Hurtig til at skrive forespørgsler.
Dokumentationen er sparsom på nogle områder, f.eks. dato- og klokkeslætsformater. Forespørgsler kører langsomt og fuldføres ofte ikke.
Forbehandling til maskinlæringspipeline. Kørsel af ad hoc-forespørgsler på kundedatabaser for at generere overordnede resuméer.
Den er meget brugervenlig. Nem at installere og bruge. Jeg kan godt lide brugerfladen.
Intet jeg kan komme i tanke om. Jeg havde en fantastisk oplevelse med at arbejde på HIVE og var tilfreds med alle funktionerne, da det opfyldte alle mine krav.
Jeg arbejdede på et skoleprojekt som en del af et Big Data-kursus, og det at udføre forespørgsler med HIVE gjorde hele projektet meget enklere.
Hive har en simpel og intuitiv brugerflade og får arbejdet gjort.
Indtil videre har Hive levet op til og overgået alle mine forventninger.
Arbejder på et Hadoop-system til at identificere rekrutteringsbureauer, der sender for meget spamm til medlemmer.
Syntaksen i Hive! Det er næsten SQL, så det er nemt at bruge. Eksterne tabeller, partitioner, buckets, UDF'er er alle de funktioner, jeg kan lide at bruge med Hive. ORC-dataformatet optager mindre plads og henter data meget hurtigere. Læringskurven ser lettere ud, da det ligner SQL, men hold fast! Du skal lære alle funktionerne i Hive, før du skriver en stor HQL-fil for at forbinde flere hundrede GB's tabeller og hente resultater. Ellers kan det tage timer at behandle det, hvis du skriver det som almindelig SQL. Så Hive er altid bedst, når du indstiller optimeringsparametrene, før du kører dine scripts. Dens komplekse datatyper gør også Hive mere nyttig end andre RDBMS'er.
Hive er forholdsvis langsommere end sine konkurrenter. Det er nemt at bruge, men det kommer med omkostninger til behandling. Hvis du kun bruger det til batchbehandling, er Hive fint nok.
Generering af datasæt fra store filer til rapporteringsformål.
Dens ydeevne ved hjælp af distribueret beregning
Begrænsede muligheder for optimering af forespørgselsydelse
Det er meget godt til OLAP-relaterede opgaver